
1. 16:56 17/08/2026
Một mô hình có thể đạt kết quả tốt khi đánh giá offline nhưng suy giảm sau vài tuần hoặc vài tháng vận hành. Nguyên nhân không nhất thiết nằm ở thuật toán. Có thể thế giới thực đã thay đổi, khiến dữ liệu đầu vào hoặc mối quan hệ giữa dữ liệu và nhãn không còn giống thời điểm huấn luyện. Hai hiện tượng quan trọng cần theo dõi là data drift và concept drift.
## Phân biệt các loại thay đổi
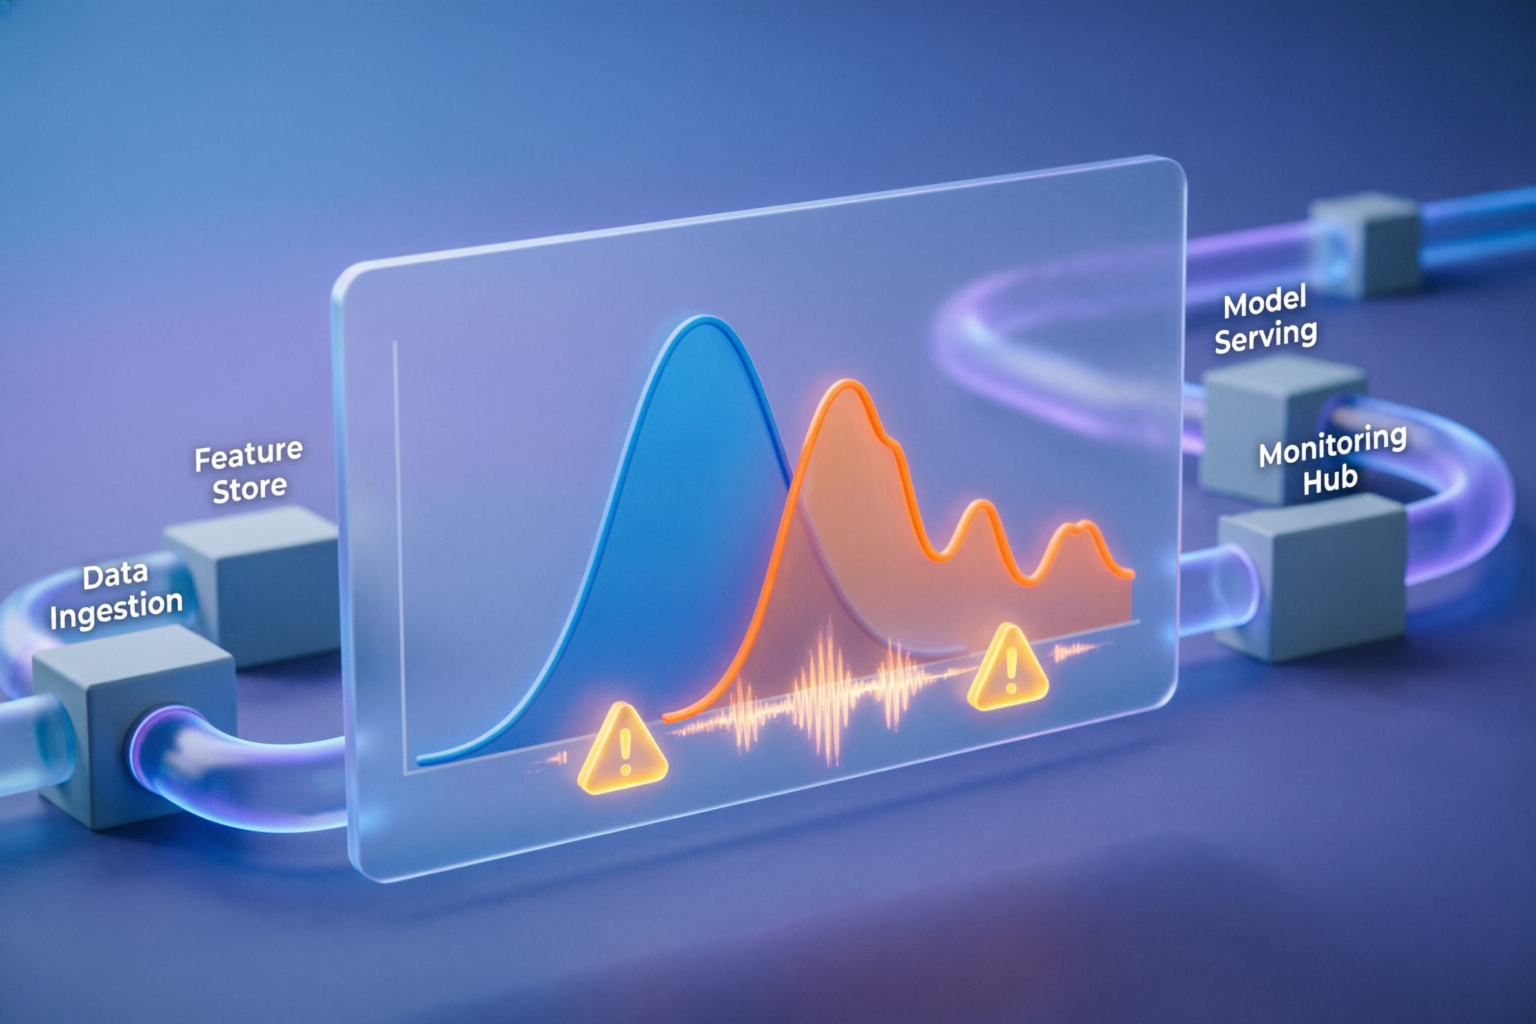
Data drift là sự thay đổi trong phân phối của dữ liệu đầu vào. Ví dụ, mô hình dự đoán khách hàng rời bỏ dịch vụ được huấn luyện khi phần lớn người dùng truy cập bằng máy tính, nhưng sau khi ứng dụng di động phát triển, tỷ lệ truy cập từ điện thoại tăng mạnh. Các đặc trưng như loại thiết bị, thời lượng phiên và số lần đăng nhập có thể lệch khỏi dữ liệu huấn luyện.
Concept drift xảy ra khi mối quan hệ giữa đặc trưng và nhãn thay đổi. Chẳng hạn, cùng một mức tần suất mua hàng trước đây có thể cho thấy khách hàng trung thành, nhưng sau khi chính sách thành viên thay đổi, hành vi này không còn mang cùng ý nghĩa. Trong trường hợp này, dữ liệu đầu vào có thể trông khá giống trước đây nhưng mô hình vẫn dự đoán kém.
Ngoài ra, cần phân biệt label drift: tỷ lệ các lớp mục tiêu thay đổi, chẳng hạn số giao dịch gian lận tăng theo mùa. Đây là tín hiệu đáng chú ý nhưng chưa đủ để kết luận mô hình đã hỏng.
## Nên giám sát những gì?
Một hệ thống giám sát thực tế nên có nhiều lớp, thay vì chỉ nhìn vào một chỉ số drift.
- Kiểm tra schema: kiểu dữ liệu, cột bị thiếu, giá trị ngoài miền hợp lệ, đơn vị đo và thời điểm cập nhật.
- Theo dõi chất lượng đặc trưng: tỷ lệ giá trị khuyết, số lượng giá trị duy nhất, độ trễ dữ liệu và các giá trị bất thường.
- So sánh phân phối: với biến số có thể dùng KS test, Wasserstein distance hoặc PSI; với biến phân loại có thể so sánh tỷ lệ từng nhóm hoặc dùng Jensen-Shannon divergence.
- Theo dõi đầu ra mô hình: phân phối điểm số, tỷ lệ dự đoán dương và thay đổi theo từng phân khúc người dùng.
- Đánh giá khi nhãn đến muộn: precision, recall, F1, MAE hoặc các chỉ số phù hợp với bài toán cần được tính trên cửa sổ thời gian mới nhất.
Các ngưỡng cảnh báo chỉ nên xem là điểm bắt đầu. Một mức thay đổi có thể bình thường trong mùa cao điểm nhưng đáng lo trong giai đoạn ổn định. Vì vậy, ngưỡng cần được xác định dựa trên lịch sử, chi phí sai lầm và mức độ quan trọng của từng đặc trưng.
## Thiết kế baseline đúng cách
Baseline không nên chỉ là toàn bộ tập huấn luyện gộp lại. Hãy lưu phân phối theo thời gian, khu vực, loại khách hàng hoặc phiên bản sản phẩm. Với dữ liệu có tính mùa vụ, nên so sánh tuần này với cùng kỳ phù hợp thay vì luôn so sánh với tuần trước.
Đồng thời, quá trình tạo baseline phải dùng đúng pipeline biến đổi như lúc huấn luyện và suy luận. Nếu một đặc trưng được chuẩn hóa, gom nhóm hoặc mã hóa trước khi đưa vào mô hình, cần giám sát cả dữ liệu trước và sau bước biến đổi khi cần thiết. Nếu không, cảnh báo có thể phản ánh sai khác do pipeline chứ không phải do môi trường thực tế.
## Quy trình xử lý cảnh báo
Khi phát hiện drift, không nên lập tức huấn luyện lại mô hình. Có thể thực hiện theo các bước sau:
1. Kiểm tra xem thay đổi có xuất hiện đồng thời ở nhiều nguồn dữ liệu hay chỉ một nguồn.
2. Đối chiếu với các sự kiện kinh doanh như thay đổi giao diện, chiến dịch tiếp thị, chính sách giá hoặc lỗi hệ thống.
3. Xác nhận dữ liệu có bị trễ, trùng, thiếu hoặc thay đổi đơn vị đo hay không.
4. Đánh giá tác động trên từng lát dữ liệu, thay vì chỉ dùng một chỉ số trung bình.
5. Nếu đã có nhãn mới, kiểm tra hiệu năng thật và so sánh với mô hình đang chạy.
6. Chọn hành động: sửa đường ống dữ liệu, điều chỉnh ngưỡng, cập nhật đặc trưng, huấn luyện lại hoặc tạm thời chuyển sang mô hình dự phòng.
Một cách an toàn là triển khai mô hình mới ở chế độ shadow hoặc champion-challenger. Mô hình mới nhận cùng dữ liệu nhưng chưa ảnh hưởng đến quyết định sản phẩm. Sau khi theo dõi đủ thời gian và kiểm tra các nhóm quan trọng, mới cân nhắc chuyển lưu lượng.
## Những sai lầm thường gặp
Cảnh báo quá nhiều khiến đội vận hành bỏ qua tín hiệu thật. Không phải mọi thay đổi phân phối đều làm giảm hiệu năng. Ngược lại, chỉ theo dõi đầu vào cũng không phát hiện được concept drift. Một sai lầm khác là retrain tự động ngay khi có cảnh báo mà không kiểm tra chất lượng nhãn, vì mô hình mới có thể học cả lỗi hoặc thiên lệch mới phát sinh.
Checklist tối thiểu nên gồm: kiểm tra schema mỗi phiên bản dữ liệu, lưu baseline có thời gian, giám sát đặc trưng và đầu ra, đo hiệu năng khi nhãn xuất hiện, phân tích theo phân khúc, ghi nhận nguyên nhân cảnh báo và có quy trình rollback. Khi coi drift là một phần của vận hành mô hình thay vì sự cố bất ngờ, đội ngũ sẽ chủ động hơn trong việc bảo vệ chất lượng AI.